信息熵与赫夫曼算法
介绍
信息论
信息熵是信息论第一个研究的对象。在通信理论中,数据压缩的极限值对应信息熵,可靠传输速率的极限值对应信道容量,而信道容量通常由输入信号与输出信号的最大互信息决定。
赫夫曼算法不同于其他的编码,比如Shannon-Fano-Elias编码,它是一种基于最优树的码字算法。对于有限字符长度的信息,赫夫曼算法得到的编码期望长度更短,不过两者的平均码长在 H 和 H+2 之间。
对于信息熵有计算公式:
里面的$-log_2\, p(x)$叫自信息量,意思是事件x发生这条消息能带来多少信息:概率越小,真发生的时候越让人意外,信息量就越大;概率为1的事件不带来任何信息,自信息量是0。信息熵就是自信息量的期望,可以理解成这个信源平均每次能提供多少信息,或者说平均有多不确定。
对于条件事件的信息熵,我们还可以通过两个随机变量写出联合熵,它的形式如下:
简单的计算化简,还可以得到链式法则:
这里$H(Y|X)$是条件熵,表示知道了X之后Y还剩下多少不确定度,定义是:
链式法则推起来也顺手,把$p(x,y)=p(x)p(y|x)$代进联合熵的定义,对数拆成两项,求和符号分开,第一项凑出$H(X)$,第二项就是$H(Y|X)$。特别地,如果X和Y相互独立,$p(y|x)$就是$p(y)$,这时候$H(X,Y)=H(X)+H(Y)$,联合熵等于两个熵直接相加。顺带说一个常用的不等式:$H(Y|X)≤H(Y)$,也就是知道了X之后,Y的不确定度只会减少或者不变,不可能凭空变大——最多就是X和Y八竿子打不着,条件熵等于原来那个熵。
χ是第二十二个希腊字母,读音类似英语单词He,读作/chi/
当然,不管概率均匀不均匀,信息熵都能算,而且各事件概率越接近均等,熵就越大,全都等概率的时候熵取到最大值log n;概率越集中,熵就越小。对数以2为底时 H(x) 的单位是 bit,换成 ln p(x) 得出的单位就是 nat。H(x) 恒大于等于0,也就是熵的非负性,因为 p(x) 落在0和1之间,log 出来的值不会是正的。从表达式也能看出,H(x) 是关于概率分布的泛函,换个分布,熵就跟着变。
其他类型的编码比如信源编码和费诺编码,原理都是相通的,出于对图论的学习,我就不说了。
图论
对于树,我们可以区分为使用有向边连接的有向树和无向边连接的无向树,对于一个有限的码字,假设它的长度为n,它可以自前向后分割为n个不同长度的子串,这些叫码字的前缀,而如果存在一个集合,它是一个有限长度码字前缀的集合,前缀之间不互相为前缀,那么叫集合内元素为前缀码,如果前缀码只使用了0和1表示,就说它是二元前缀码。
为什么要强调“前缀之间不互相为前缀”?因为编码是把码字一个个拼起来发的,接收端从左往右读,读到哪一段正好凑成码字就切下来译码。要是某个码字是另一个码字的前缀,读到一个短码字时就不知道是该停还是该往后读,译码就乱了。前缀码没有这个问题,任何一个码字都不是别的码字的开头,所以能一路切下去。
码长也不是随便定的,码长为$l_1,l_2,…,l_n$的二元前缀码存在,当且仅当满足Kraft不等式:
拿后面的例子验证一下,A、B、C、D的码长分别是3、3、1、2,$\frac{1}{8}+\frac{1}{8}+\frac{1}{2}+\frac{1}{4}=1$,不多不少正好用满。这也算是个判断码长合不合理的小办法,一组码长要是连这个约束都过不了,那肯定构造不出对应的前缀码。另外记住一个结论:赫夫曼这种最优前缀码的平均码长L一定满足$H(x)≤L<H(x)+1$,下界是信息熵,上界比熵最多多1个比特,实际平均长度具体是多少,就得把树建出来数了。
假设一个含权二元树,它使得所有叶子结点的带权路径长度之和最小,也就是满足下面表达式,其中L(w)表示结点所在层,求出的w(T)就是树权。
这里的权重就是叶子对应符号的概率,L(w)是叶子到根经过的边数,也就是码字长度,所以树权w(T)算出来正好是平均码字长度。树权越小,编码越短,要找的就是让这个和最小的那棵树。
赫夫曼算法主要完成下面四个步骤:
- 1、将所有的结点含权放入集合C中
- 2、从C中取出权重最小的两个结点,作为儿子,连接为父亲,父亲的权重为两个儿子权重之和
- 3、在C中去除两个儿子结点,加入父亲结点
- 4、判断C中是否只剩一个结点,不是则返回第二步
这个贪心思路的依据是:权重最小的两个符号肯定待在最深的叶子上,并且互为兄弟,因为让权重小的离根远一点、权重大的离根近一点,带权路径长度才会小。把最小的两个先合起来,相当于先给它俩安排好最底层的位置,父亲带着两人的权重和再回去参加下一轮比较,一层层往上长,最后根结点的权重正好是1。
通过赫夫曼算法得到的根树就是最优树。从根开始依次给边赋权,左子树为1,右子树为0,那么就可以得出最优前缀码。注意赫夫曼树不是唯一的,合并时左右可以换,遇到权重相同的结点选谁先合也有多种选法,码字可能长得不一样,但平均码字长度都是同一个最小值。
举例子
Minloha打算使用单片机通过传递电磁波完成选择题答案的传输,请你帮他设计一份编码,使数据传输最简洁。据统计,选择题出现A的概率为22%,出现B的概率为13%,出现C的概率为37%,出现D为28%
这题是单变量,那我们就用信息熵算出最大压缩量
我们简单地计算一下,得到H(x)=1.90816694686,取整为2,也就意味着平均码字长度能做到接近2个比特,但那只是理论下界,实际编码长度得靠赫夫曼树算出来,那我们画出它的二元树:
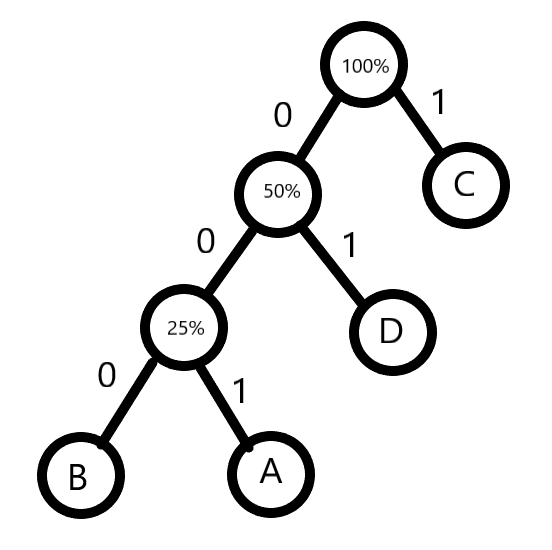
建树的过程捋一遍:先把权重最小的B(0.13)和A(0.22)合起来,父亲权重0.35;剩下的集合里0.28和0.35最小,把D(0.28)和0.35合起来,父亲权重0.63;最后0.63和C(0.37)合并,根结点的权重为1。从图上能直接读出,A表示为001,B表示为000,C表示为1,D表示为01,那么我们算一下平均码字长度,大小为0.22×3+0.13×3+0.37×1+0.28×2=1.98,比较接近我们的信息熵大小。
作为对比,我们也算一下香农码,香农码计算公式为:
这个式子的意思就是让每个符号的码长贴近它自己的自信息量,概率小的编长一点,概率大的编短一点,外面的向上取整是因为码字长度必须是整数位。分别计算一下,可以算出A的码字长度为2.18442457114取整为3,B的码字长度为2.94341647163取整为3,C的香农码字长为1.43440282415取整为2,D长1.83650126772取整为2,列表看看赫夫曼码字长度和香农码字长度大小比较
| 字符 | 理想码字长度 | 取整后码字长度 | 赫夫曼码字长度 |
|---|---|---|---|
| A | 2.18442457114 | 3 | 3 |
| B | 2.94341647163 | 3 | 3 |
| C | 1.43440282415 | 2 | 1 |
| D | 1.83650126772 | 2 | 2 |
可以看出赫夫曼编码还是十分契合理想码字长度的,香农码只能一位一位地向上取整,赫夫曼码更灵活,平均长度也就更短一些。费诺编码也是从概率出发,把符号按概率大小分成两组往下分,构造简单,但平均码长不一定能做到最小;赫夫曼算法从下往上合并,最后得到的是最优树,所以实际用的也更多一些。
总结
信息熵与赫夫曼编码的概念就讲到这里,笔算方法上面都演示过了,感兴趣的话可以用自己熟悉的编程语言实现一遍。