浅谈图论
发展历史
在现在的计算机网络工程中,最不可或缺的就是拓扑图,其实拓扑图就是图的一个变种,把网络里的主机画成点、网线画成边,一张图就能把连接关系说清楚。拓扑学和图论的区别是应用场所不同:图是我们把实际问题抽象成点和边之后拿来做分析的工具,而拓扑是切实通过代数运算去研究空间性质的工具,拓扑应用得较多就是泛函分析,后面可能会说。图论在现代应用于线性代数或者密码学中,涉及表达的地方,都会有图存在,比如编译器里的控制流图、社交软件里的好友关系,甚至电路分析,都能画成图来处理。
图论是数学领域中发展最快的分支之一。数学史上著名的七桥问题,说的是哥尼斯堡城中有一条河,河中间有两座小岛,七座桥把两岸和小岛连在一起,问能不能一次走遍七座桥、每座桥只走一次再回到出发点。欧拉没有真去桥上走一遍,而是把两岸和小岛抽象成四个点,把桥抽象成边,问题就变成了这个图能不能一笔画完,他在1736年证明了不重复地通过7座桥的路线是根本不存在的!这也是拓扑学研究的先声。图的染色问题一直是图论研究的焦点问题,问的是给一张地图染色,相邻的区域颜色不能相同,最少需要准备几种颜色。数学家赫伍德(Heawood)成功地运用肯普的方法证明了五色定理,即一张地图能够用五种或者更少的颜色染色。美国伊利诺斯大学的黑肯(W.Haken)和阿佩尔(Appel),经过四年的艰苦工作,终于完成了四色猜想的证明,这份证明还动用了计算机帮忙验证大量情况,在当时引起了不小的轰动。正是上述那些似乎没有多大意义的游戏的抽象与论证的方法,开创了图论科学的研究。
图
点和边
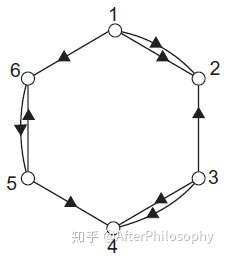
图论的要素就是点和边了,点没什么说的,用一个空心圆表示点,边就是把两个点连起来的线。边有区别,在离散数学的二元关系的一章中,会知道二元关系就是图论中的一种叫有向边的边,在图上表现出序偶的第一元素用箭头指向第二元素。写出来一个从a到b的二元关系为<a,b>。如果描述的是集合之间的二元关系如A和B,那么就可以写为笛卡尔积A×B表示A与B之间的二元关系,也就是把A里的元素和B里的元素两两配对,所有配对组合成的集合就是笛卡尔积,而二元关系就是这个大集合的一部分或者全部。相似的,A到B集合也可以从函数角度分析,A集合通过映射f到B集合,为了映射达到满射,引出了函数的置换,记作:
其中n叫做置换阶,常见的比如切比雪夫多项式,就是一种置换函数。有向边组成的有向图的一个性质是度(degree),对于一个点它可以有出度和入度,表示为deg(v),出度就是从它指出去的边数,入度就是指向它的边数,把每个点的度数按规律排出来,就可以拿来判断两个图是不是同构,不过度数序列一样只是必要条件,一样不一定同构,不一样就肯定不同构。相似复习一下二元关系在有向图的性质,也就是下面的三个性质。
- 自反性(r)
- 对称性(s)
- 传递性(t)
在初学二元关系就已经引入图了,所以有向图应该是接触较早的。在学习二元关系中有一个难点,就是等价关系和次序关系,等价关系是一个同时具备自反性,对称性和传递性的关系R,在它的元素集合A中,满足:
同时对于关系R,它的第一元素组成的集合是集合A的等价类。等价类有个特点:同一个类里的元素互相都有关系,不同类之间的元素一定没有关系,整个集合A会被等价类切得干干净净、互不重叠,这一点在后面的连通分支上还会再见到。次序关系中比较难的就是偏序关系,拟序关系还好说,拟序集用符号<A,<>表示,偏序集用符号<A,≤>表示。对于偏序关系R,它要有自反性、反对称性和传递性,通俗地说就是能比较大小、允许并列的关系,比如集合的包含关系就是典型的偏序。这里会引出哈斯图的概念,不过无非就是省略自环和箭头的图,把小的元素放在下面、大的放在上面,有直接覆盖关系的点之间连条线,细节就不展开了。同时对偏序关系的特殊元素还要记得,最大与极大、最小与极小,不一定同时存在,最大元要求它和所有元素都能比较,所以最多只有一个,极大元只要求没有比它更大的元素,可以同时有好几个。
如果两元素不存在向性关系,也就是无序,那就可以用无序对表示,同样,对于元素a、b它的无序对表示为(a,b)。也可以用集合的笛卡尔积表示,不复写了。一般对于一个图(Graph)点一般放进集合V,边放进集合E,则对于一个图可以记作G=<V,E>,可以画图或者使用邻接矩阵表示:矩阵的第i行第j列如果是1,就表示点i到点j有一条边,是0就是没有,无向图的邻接矩阵一定是对称的。矩阵也有类似矩阵方程的计算,离散中独有的就是布尔乘积,它是通过类似矩阵乘法的叉乘,不过最终点是通过析取联结词运算的,也就是把普通乘法的乘换成合取、加换成析取,算出来的每个位置非0就记作1。举个例子,A里只有(1,2)位置是1、B里只有(2,3)位置是1,那么A和B的布尔乘积在(1,3)位置就是1,表示存在1→2→3这样一条长度为2的通路。把邻接矩阵反复做布尔幂,就能数出任意长度的通路,这些结果再合起来就是可达性矩阵,图里哪些点能走到哪些点就一目了然了。
图的性质
对于有向图,一个节点v,它有n个以它为第二元素的序偶,则它的入度为n,记作$deg^-(v)=n$;反之有m个以它为第一元素的序偶,则它的出度为m,记作$deg^+(v)=m$,入度和出度要分开数,别混成一个。对于整个图中,最大度记作Δ,最小度记作δ,最大最小出入度就是分别在右上角标号。而握手定理描述的就是下面的式子:
含义就是所有度数加和应为边数的二倍。为什么正好是二倍呢?因为一条无向边有两个端点,每数一条边就会给两端各贡献1度,把所有点的度数加起来,相当于每条边被数了两遍。有向图里则是所有出度之和等于所有入度之和,并且都等于边数。还有个容易忽略的坑:自环既是自己的出边也是自己的入边,在无向图里给它贡献2度,在有向图里入度出度各贡献1,数度数的时候别漏了。
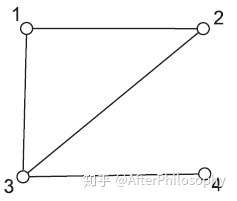
无向图中,任意两个结点之间都存在通路能相互到达,就说两点是连通的,注意这里说的是有路径就行,不要求两点之间直接连着一条边,通常用连通性矩阵P表示,P里的元素用1表示可达、0表示不可达。如果连通性矩阵的每一个元素都是1,那么图叫做连通图,反之叫做非连通图。自然的,图的等价类所有的导出子图都被称作连通分支,一个图可以有好几个连通分支,分支内部随便走,分支之间一条边都没有,直观上就是把图分成了几块。而对于连通度,如果图G满足:
则V’’叫做点割集,如果|V’’|=1则叫做割点。式子里的p(G)表示图中连通分支的个数,删除V’’的时候要把它身上的边一起删掉,删完分支变多了,说明这几个点卡在了关键的连接位置上。同理如果图G满足:
则E’’叫做边割集,如果|E’’|=1叫做桥。而根据割集元素数量和种类,就引出了连通度的概念,即k(G)=min{|V’’| | V’’是点割集},结果就是连通度k,V’’是点,则叫做k-连通图,反之k(G)=min{|E’’| | E’’是边割集},结果是连通度k,叫做k边-连通图,式子里的min说的是在所有割集里挑元素最少的那种,连通度越大,图就越抗折腾。这里有个常见的误区:不能光看度数就断定一个点是不是割点。比如一个简单的圈,每个点的度数都是2,可删掉任意一个点圈就断了,它们都是割点;而完全图里每个点度数都很大,删掉一个图照样连通,反倒不是割点。所以判断割点要老老实实按定义数分支,别图省事。假设一个图,如果忽略所有有向边的方向后是连通的,就说图是弱连通,如果存在一对结点是连通的,就说是单向连通,如果任意节点均可达,就说是强连通的,这三种条件是层层加强的,强连通一定是单向连通,单向连通一定是弱连通,反过来不一定。假设等价关系的导出子图具有连通性,并且是有强弱之分,那么就可以分别命名为强连通分支,弱连通分支和单向连通分支。
对于边是含权的,如果需要计算任意两节点间的路径长度和最短路径,就需要下面两个算法。先说清楚权是什么:一条边上的权可以代表距离、花费、时间这些代价,一条路径的长度就是把路上所有边的权加起来,最短路径就是在所有可行路径里长度最小的那条。注意经过的边数最少和总权最小是两码事,绕远路但每段都便宜,总代价反而可能更小。最短路径问题一般分两类:一类是单源最短路径,算一个起点到其他所有点的距离;另一类是多源最短路径,算任意两点之间的距离,正好对应下面的Dijkstra和Floyd。
算法
Dijkstra算法
如果你有学习过算法,你一定对它不陌生,它通过不断确定“已经找到最短路的点”,求出一点到其余各点最短路径,出于理解,我会用C++完成这个算法。Dijkstra算法的思路是贪心:先确认起点的距离是0,然后每一轮从未确定的点里挑一个当前距离最小的,把它确定下来,再用它去更新一圈邻居的距离,一直重复到终点被确定为止。这个贪心能成立有个前提,就是边权不能是负数,因为如果存在负权边,已经确定的最短距离后面还可能被一条负边改小,贪心的前提就没了,所以Dijkstra只能处理非负权图,这是最常见的坑之一。用优先队列实现的话,复杂度大致是O((V+E)logV)这个级别,跑一般的题完全够用。
- 第一步,把起点的距离标为0,其余所有结点到起点的距离先记作∞,把起点邻居的距离填进距离表
- 第二步,在还没确定的结点里挑出距离最小的那个标记为已确定,然后用它去更新邻居的距离表:如果从起点到当前点的距离加上这条边的权,比邻居原来记录的距离更小,就替换掉,这个动作叫松弛
- 第三步,重复第二步,直到所有点都被标记完,或者终点被标记
1 | |
你可以用此算法完成自己的图与Dijkstra距离。代码里有几个值解释一下:Dist初始化用的0x3f3f3f3f是算法题里常用的“无穷大”,大概10亿,好处是两个这样的数相加也不会把int撑爆;priority_queue默认是大顶堆,所以State里重载的operator<把比较反了过来,让距离小的排到堆顶,就相当于一个小顶堆;mark数组记录点是否已经确定,防止重复处理。另外这版代码建图时正反方向各加了一条边,跑的是无向图,如果是有向图,把cargarGrafo里反向那条去掉就行。优先队列里同一个点可能被压进去好几次,这是堆优化的正常现象,不影响结果。还有,找不到通路的时候代码会返回-1。
Floyd算法
这个算法的完整C++版本我短时间写不出来,那就只能说说流程和核心代码了呀~
- 先把图的加权邻接矩阵列出来:自环距离为0,直接相连的边填权值,不可一步到达的位置记作∞
- 然后一轮一轮地加中转点:第k轮只允许经过编号不大于k的点当中转,拿第k行第k列的数据去更新其他位置,如果绕一下更短就把原来的值替换掉,得到新矩阵
- 当k加到结点个数时停止计算,这时矩阵里每个位置就是对应两点之间的最短距离
相关的公式如下:
规定d为D的某行某列元素,则满足:
而d的计算满足:
公式里 $D^{(k)}$ 表示只允许经过前k个结点中转时,任意两点间的最短距离,$d^{(k)}_{ij}$ 就是它的第i行第j列,min里的两项分别是“不经过第k个点中转”和“经过第k个点中转”两种情况,第二种就是把路程拆成 i→k 和 k→j 两段,两者取小就是新的最短距离。
核心代码就三层循环:
1 | |
这里有个坑:k这一层一定要放在最外面。Floyd是按“允许经过的点集”一轮一轮扩展的,k要是放在里面,dist[i][k]和dist[k][j]可能在当前这轮还没更新完,拿半成品去更新i到j,结果就不对了。初始化的时候同理,不通的地方要设成一个足够大的数,但也要小心两个“无穷大”相加会溢出,比较前可以先判断一下dist[i][k]是不是无穷大。
而如果手算Floyd就十分有趣了,画出图的加权邻接矩阵,然后每轮挑一个点当中转站,把它所在的行和列的元素两两相加,能变小就填回去,所有点轮完之后,矩阵里的数字就是不同起点到不同终点的最短路径了。
Dijkstra代码源自https://github.com/jpieroabarcam/Dijkstra.git,仅仅去掉注释和汉化一下
总结
图论说到底就是点和边两样东西,度数、连通性、割集这些概念都是围着它们转的,理清定义之后自己画两个图练练手就全明白了。最短路径的两个算法里,Dijkstra适合单源、非负权,Floyd三层循环就能算出任意两点之间的最短距离,各有各的场合,别混着用。感兴趣的可以拿这两个算法把自己游戏或者项目里的寻路跑一遍,手算Floyd的过程其实比看代码还有意思。