关于22年电赛省赛实现传统视觉做倒车入库

分析

首先与机械组做好协调,使用TTL串口通信传递指令,我们约定好一条指令三个字节:第一个字节是控制前进、后退、停止的指令,第二个字节是前轮的角度,第三个字节是云台的角度。指令直接用十六进制的字节发,不做字符串解析,简单可靠,TTL串口点对点传这点数据也用不上复杂的协议。这样我们就可以完全使用视觉控制系统完成倒车,视觉做什么决定,小车就做什么动作。

三个字节里的约定是:第一个字节0是停止、1是前进、2是后退,前轮角度范围正负45度,云台角度范围正负90度,都按度数值直接发。发完一条指令不能马上发下一条,得给车留出执行动作的时间,不然轮子还没转到位就被新指令打断,这个在后面说代码的时候再提。串口波特率用的是115200,3个字节眨眼就传完了,延迟不在串口这边,真正花时间的是图像采集和特征匹配。当然这种裸协议也有隐患,三个字节没有包头包尾,全靠位置对齐,中间丢一个字节整条指令就错位了,正经场合得加校验,我们图省事就没上。

对于电控的部分,使用了STM32F103C8T6,舵机用了5个2g舵机,主动轮用了传统无刷电机,通过STM32修改PWM的占空比实现了舵机任意角度的旋转。舵机定角度的原理就是看高电平持续的时间,一般0.5ms到2.5ms的脉宽对应转动范围的两头,周期固定给20ms,脉宽一变角度就跟着动,所以想要哪个角度就去调对应的脉宽。不过电控我没看,主要描述一下使用的视觉算法以及我期望的视觉算法。

首先我们分析一下特征,每个停车位都有一个箭头,所以我们需要识别它,至于倒车入库具体的实现交给STM32完成,所以我们视觉只需要通过串口告诉STM32:我看到了箭头即可。识别到箭头以后就发一条“后退、打轮、云台回正”的指令,等车按这个姿态往库里倒,再补一条停止指令,一次动作就算完成。视觉这边不求把位姿算得多精确,能稳定地“看见”比什么都重要。

传统视觉

为了提取特征,我们可以尝试进行卷积操作用来保留特征,然后通过对象识别来找到它,比如把箭头图片存成模板,用模板匹配去找最像的位置,或者干脆训一个分类器判断“是不是箭头”。这套办法在PC上精度很高,样本管够,库也成熟。不过这里有一个很严重的问题,那就是嵌入式系统的算力并不高,OpenMV跑一帧都要精打细算,对象识别并不准确,帧率也上不去。小车是实时控制的东西,检测慢半拍或者偶尔误检,车就直接跑偏了,所以这个方案被舍弃了。

不过这种办法我也会在后面说,毕竟这种办法的精度很高

第二种就是我们使用的方法,就是特征点识别。这个方法的出发点是先搞清楚目标在图像里“长什么样”,首先我们要分析一个现实的情况:

在一个简单的光环境内,拍摄一个立体物体会有什么特点?
可以看到,在光下,自然的物体出现了阴影,也就意味着,阴影部分是一个亮度从低到高的过程。道理也简单,物体表面朝着光源的那一侧收到的光多,亮;背着光的一侧收到的光少,暗;明暗交界的地方,亮度是一点一点过渡过去的,不会凭空跳变。我用一张阴影图表示,斜线密度越大,阴影越深,光是从右上角照下来的,从图上看就是右上角的斜线密度大。
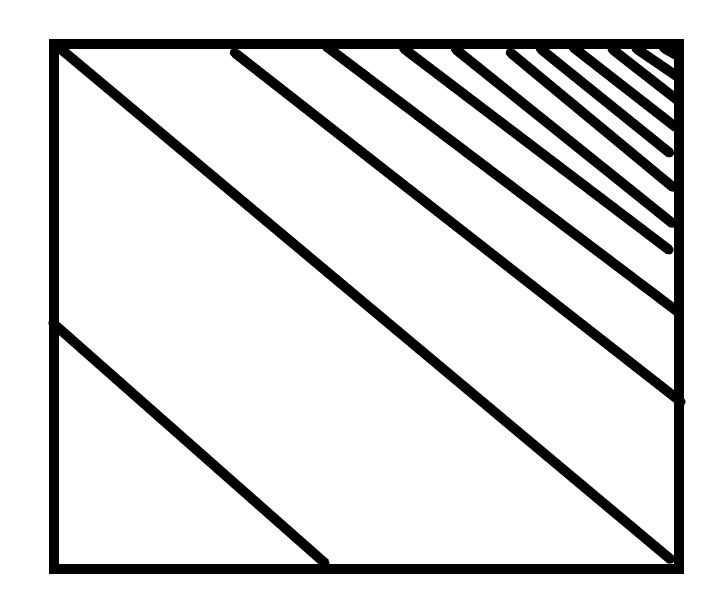
反映在灰度图片上我们可以发现,它的梯度是连续均匀地变化着的,从亮到暗,中间每一级灰度都能找到。所以我们可以得到结论,圆滑过渡的位置,灰度的变化是渐进的;而边缘位置近乎描述了物体的特征形状,图像里能用来区分物体的信息,基本都集中在灰度发生变化的这些地方,通过此法就可以获取到物体的特征。

如何实现这个过程呢?我们需要使用SIFT算法,SIFT主要分为以下两步:

  • 创建高斯金字塔
  • 确定关键点的梯度方向

严格来说SIFT的论文里分了四步:尺度空间极值检测、关键点定位、方向分配、生成描述子。我们按上面两步来理解也够用,后面两步可以并到“确定梯度方向”里,反正OpenMV都把函数封装好了,平时调参比推导用得多。

SIFT的核心是尺度空间,做法是拿不同大小的高斯核去卷积原图,得到一组越来越模糊的图像;相邻两层一相减,就得到高斯差分金字塔。一个点在某个尺度上如果是局部极值,也就是说它比同层的8个邻居、上下两层的各9个邻居都亮或者都暗,那它就被选为候选关键点。这样做的好处是,不管箭头离摄像头是远是近,总有一个尺度上它最显眼。

操作上就是先拍摄一些目标的图片,然后我们采用从大图片逐步卷积为小图片的方法,完成下采样金字塔:
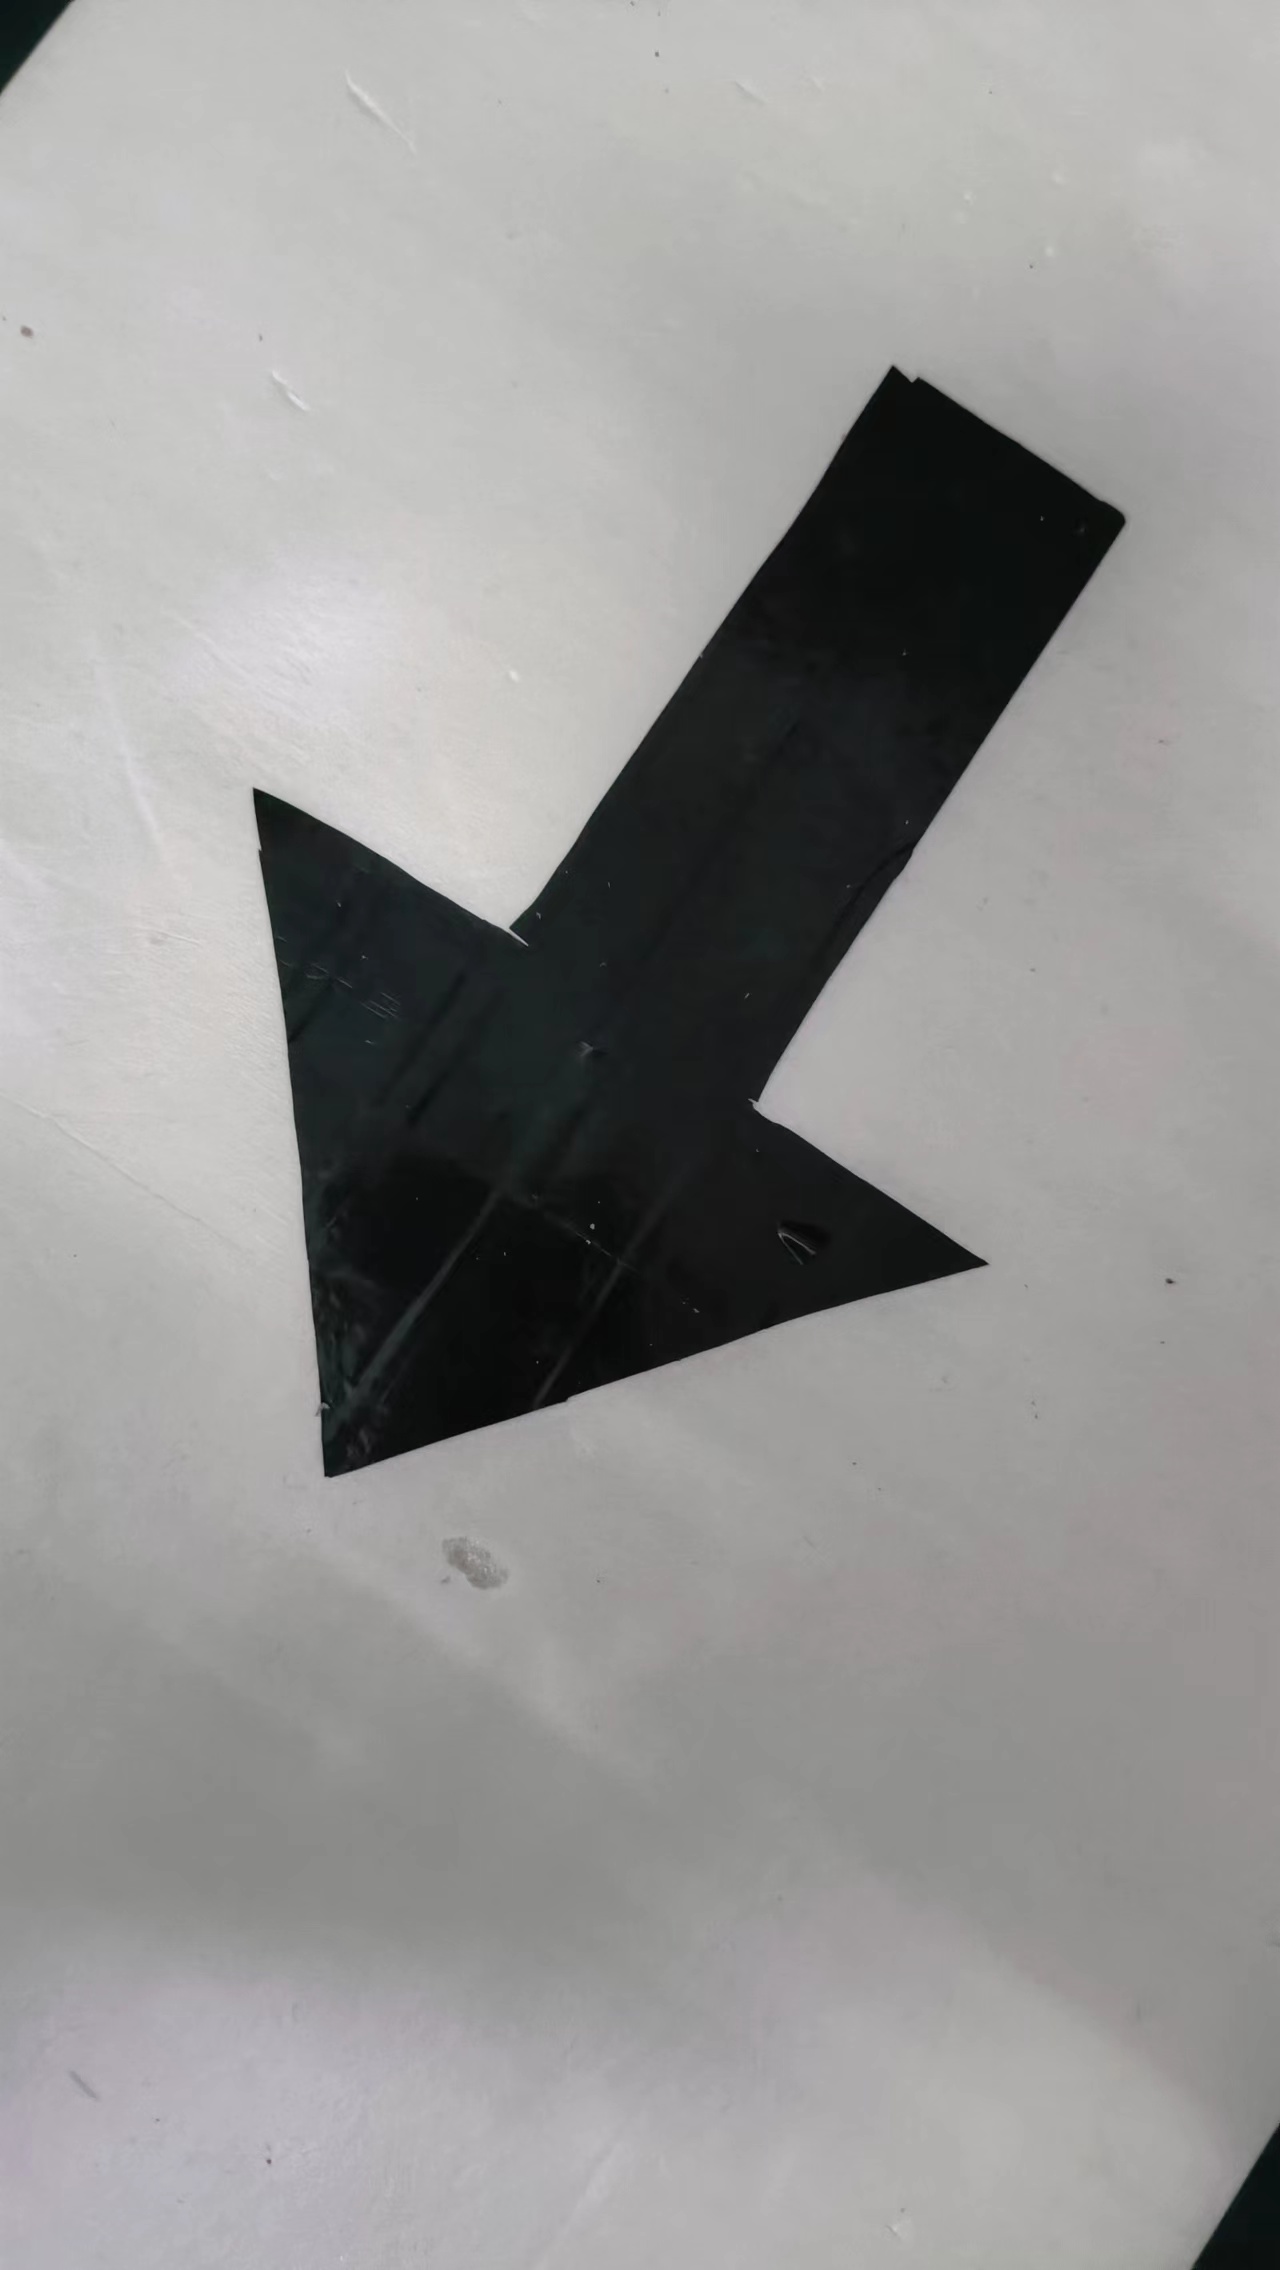
可以看到目标箭头的边角比较锐利,并未出现梯度值均匀变化的情况,而是直接的转变。黑箭头贴在白地板上,边缘两侧的灰度从白直接跳到黑,没有过渡带,这种地方在尺度空间里到处都是极值,天生适合当特征点。也正因为箭头跟地面环境“不相容”,所以我们取点要取在这种类型的物体边缘,这些点就是我们所需要的特征点。

构建过程简单来讲就是图片反复卷积,由大图变成小图,最后出来的就是特征。然后计算最后图片不同方向不同位置的梯度值,再统计主方向和描述子,这样我们就得到了很多的特征点。顺便提一句,SIFT对旋转、缩放、光照变化都比较稳,代价是计算量大,放到嵌入式上就更吃力了。

因为我们使用的是OpenMV,这些算法不需要我来完成,直接调函数就行,不过底层实现是SIFT那一套。OpenMV的find_keypoints会返回一组关键点,每个关键点都带着自己的描述子,可以把它存成.orb文件当模板,用的时候再跟视野里检测到的特征做匹配。

传感器那几行初始化也别跳过:skip_frames先丢掉前2000毫秒的画面,等摄像头自己的白平衡和曝光稳定下来再干活;set_contrast(3)把对比度拉高,箭头黑白分明,边缘更陡,特征点也更好提;set_gainceiling(16)给增益封了个顶,防止暗光下硬拉增益拉出一堆噪点,噪点多了特征点就全乱套了。分辨率上先拍VGA再用windowing裁到320×240,视野小一圈,但每帧要处理的数据量只剩原来的四分之一,对OpenMV这种小身板来说挺重要。另外图像统一转成灰度处理,颜色对认箭头帮不上忙,转灰度还能省算力。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
import sensor, image, time
from pyb import LED
from pyb import UART

sensor.reset()
sensor.set_pixformat(sensor.GRAYSCALE)
sensor.set_framesize(sensor.QVGA)
sensor.skip_frames(time = 2000)

sensor.set_contrast(3)
sensor.set_gainceiling(16)
sensor.set_framesize(sensor.VGA)
sensor.set_windowing((320, 240))

clock = time.clock()

kernel_size = 2
kernel = [4,5,6,5,4,\
5,-3,-4,-3,5,\
6,-4,-5,-4,6,\
5,-3,-4,-3,5,\
4,5,6,5,4]
# 计数器
times = 0
# 采样数
kick=10
# 加载特征
# kpts1 = image.load_descriptor("/desc.orb")

# 模板匹配
def drawAim(temps,img):
for tem in temps:
r = img.find_template(tem, 0.60, step=7, search=SEARCH_EX)
if r:
img.draw_rectangle(r)

# 发送数据
# ---- 格式 ----
# 0 stop
# 1 run
# 2 back
# x +-45 转向
# xx +-90 云台转向
# 共三个部分,使用 \x十六进制 的格式发送
def postData(Data):
uart = UART(3,115200)
uart.write(Data)

# 画出特征点
def drawKeypoint(img,kpts1):
if kpts1:
img.draw_keypoints(kpts1)
time.sleep_ms(2000)
sensor.snapshot()

# 比较特征
def consider(img,kpts1,ktps2):
if (kpts1 == None):
kpts1 = img.find_keypoints(max_keypoints=50, threshold=10, scale_factor=1.2) # 用kepts1保存函数提取到的特征
drawKeypoint(img, kpts1)
else:
kpts2 = img.find_keypoints(max_keypoints=50, threshold=10, normalized=True) # 调用函数检测视野中是否存在特征,并将检测到的特征保存在kpts2中
if (kpts2):
# 将当前找到的特征和最初的目标特征kpts1进行对比
match = image.match_descriptor(kpts1, kpts2, threshold=85)
if (match.count()>20):
img.draw_rectangle(match.rect())
img.draw_cross(match.cx(), match.cy(), size=10)
postData("\x02\x2d\x00")
time.sleep_ms(1500)
postData("\x00\x00\x00")
print(kpts2, "matched:%d dt:%d"%(match.count(), match.theta()))

# 保存特征
def saveKPT(FILE_NAME,kpt):
image.save_descriptor(kpt, "/%s.orb"%(FILE_NAME))
LED(1).on()
LED(2).on()
LED(3).on()


while(True):
clock.tick()
img = sensor.snapshot()
kpts1 = img.find_keypoints(max_keypoints=100, threshold=10, scale_factor=1.2)
# 采样
drawKeypoint(img,kpts1)
if(kpts1!=None and times<kick):
times += 1
saveKPT(times,kpts1)
else:
print("Havent point")
# 使用采样
'''
for i in range(kick):
add = "/" + str(i+1) + ".orb"
aimKpt = image.load_descriptor(add)
consider(img,kpts1,aimKpt)
# postData("\x00\x2d\x2d")
'''

代码里几个函数挨个说一下:find_keypoints负责在图像里提特征点,max_keypoints限制最多提多少个点,提多了算不过来;threshold是检测阈值,数值越小提的点越多,也越容易把噪声当成特征;scale_factor决定金字塔相邻两层之间的缩放比,设成1.2是按细粒度找,想快一点就调大;normalized=True会把描述子做归一化,对光照变化更稳一些。match_descriptor是拿两组描述子做匹配,结果里count()是匹配上的对数,theta()能给出两组特征之间的旋转关系(代码里只是打印出来看看),正好可以用来判断车和箭头之间的转角。代码里的逻辑是匹配对数超过20就认为找到了箭头,画个框,然后把“后退、打轮45度、云台回正”通过串口发出去,延时1.5秒给车执行动作,再补一条停止指令。另外postData里每次都重新建一次UART对象,能跑,但正经写应该在初始化的时候把串口建好,发数据直接发。

上面那个drawAim是模板匹配的写法,find_template用归一化互相关去找和模板最像的位置,0.60是相似度阈值,step=7是搜索步长,步子大了报得快、精度粗,SEARCH_EX是穷举搜索。drawAim 在代码里没有被调用,比赛实际用的是特征点那一套。

采样和匹配是分两次跑的:采样阶段对着箭头拍,把提出来的一组组描述子存成1.orb到10.orb;实测的时候把循环里注释掉的那段匹配代码放出来,加载模板再逐帧匹配。多采几份样本是为了让不同距离、不同角度、不同光照下的箭头都有一份参考,匹配率会高不少。

这个方法对于OpenMV来说,还是有些超负荷,所以接下来的CNN更加无法适用。

卷积神经网络

这种做法是我所希望的,因为只需要投入一定量的模型就可以识别得较为准确,特征又比较明显,所以我只使用一层隐含层,并且只有两个输出,是或不是。跟手工设计特征比起来,CNN的好处是喂图片和标签就行,光照、距离、角度这些变化它自己会从数据里学,不用一条条去调阈值。下面是结构图:
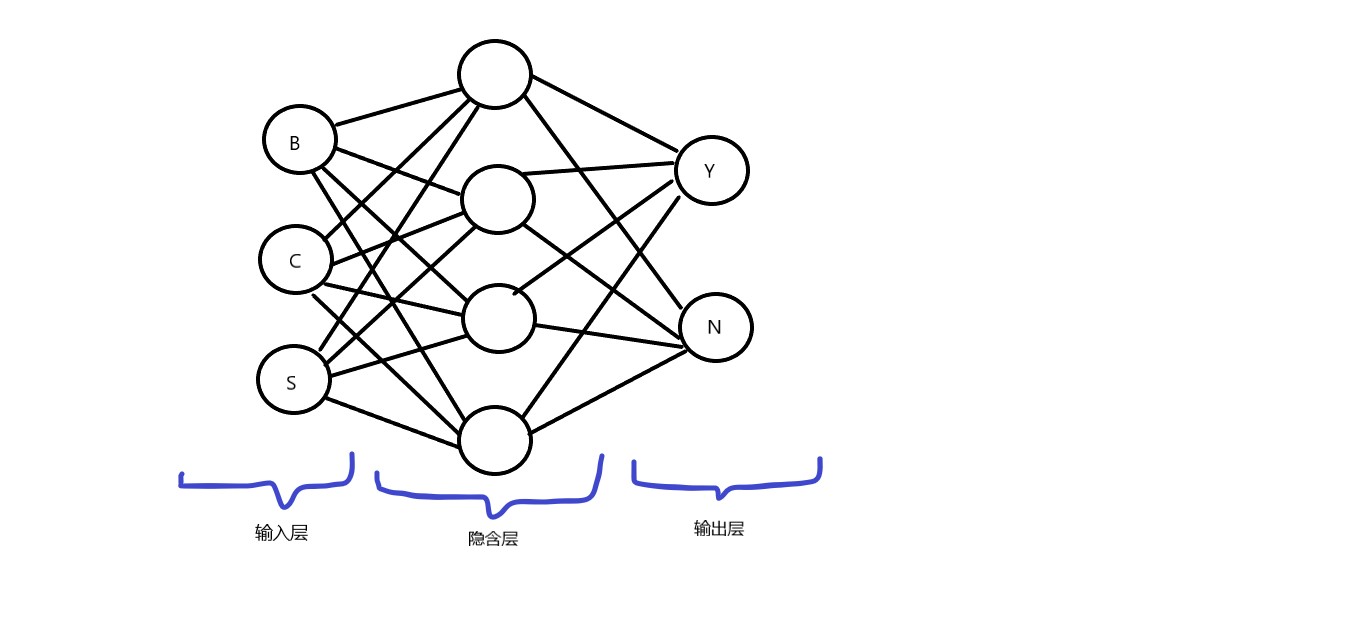
关于CNN的介绍我也就不再复习了,总体上可以参考我之前写过的文章,为了实现的简单与方便,我这里使用了Tensorflow完成操作,但是毕竟嵌入式的算力有限,没办法用CUDA,只能拿CPU算,如此只能简单的完成了。要不是板子跑不动,这个方案其实是最省心的。

玻尔兹曼机:https://blog.minloha.cn/2022/10/24/%E7%8E%BB%E8%80%B3%E5%85%B9%E6%9B%BC%E6%9C%BA/

神经网络的理解:https://blog.minloha.cn/2021/12/13/%E4%B8%80%E4%BA%9B%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C%E7%9A%84%E7%90%86%E8%A7%A3/

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
import numpy as np
import tensorflow as tf
from tensorflow import keras
from keras import layers, losses, optimizers
import cv2
import os
from queue import Queue

# ----- 输入寄存 ----
trainQueue = Queue()


# ---- 读取数据文件夹,一定是一个类别的
def loadImgToMatrix(imgsPath):
for img in os.listdir(imgsPath):
print(img)
aimg = cv2.imread(imgsPath + img)
aimg = cv2.cvtColor(aimg, cv2.COLOR_RGB2GRAY)
trainQueue.put(np.array(aimg))


# 训练一个网络,返回这个网络
def trainNN(aim):
criteon = losses.CategoricalCrossentropy(from_logits=True)
y_train = np.random.randint(1, size=(1, 2))
model = keras.Sequential({
layers.Conv2D(81, kernel_size=3, padding='SAME', strides=3),
layers.MaxPool2D(pool_size=2, strides=2),
layers.ReLU(),
layers.Conv2D(81, kernel_size=3, padding='SAME', strides=1),
layers.MaxPool2D(pool_size=2, strides=2),
layers.ReLU(),
layers.Flatten(),
layers.Dense(120, activation='relu'),
layers.Dense(81, activation='relu'),
layers.Dense(2),
})
for q in range(trainQueue.qsize()):
x = q.get()
# 使用自适应动量法进行参数优化
model.compile(lose='softmax', optimizer='Adam', metrics=['accuracy'])
model.fit(x, y_train, epochs=1, batch_size=81)
y_out = tf.one_hot(y_train, depth=10)
loss = criteon(y_out, aim)
print(loss)
model.summary()
return model


if __name__ == "__main__":
loadImgToMatrix("example/")
trainNN(np.array([1, 0]))

代码本身不复杂:loadImgToMatrix把文件夹里的样本图读成灰度矩阵存进队列,trainNN搭了一个几层卷积加全连接的网络,最后输出两个数,对应“是箭头”和“不是箭头”。这套网络放在电脑上训练没问题,塞进OpenMV就完全是另一回事了,算力就那么多,实时控制根本等不起。

最后经过一夜的模型训练,精度几乎100%。

总结

这次比赛最后还是输了,关键点忽然就全部消失了,实际测试的时候OpenMV的线程又卡死了,导致完全没办法跑完全程,只能说全都是经验吧!现在回头看,特征点这种方案对现场环境太敏感,光照一变、箭头脏一点,之前采的模板可能就全对不上了。以后再做类似的题,得多留一手兜底方案,不能把宝全押在一种特征上。


关于22年电赛省赛实现传统视觉做倒车入库
https://blog.minloha.cn/posts/1516079e4e2e5a2022101631.html
作者
Minloha
发布于
2022年10月16日
更新于
2022年10月16日
许可协议