随机数怎么样随机的
介绍
都说计算机的随机都是伪随机,其实无论是生活的各个角落都是伪随机而不是真随机,真随机可能真的不存在,所有的事件都可以用简单的P(A)表示,无论是否有条件,那么我们如何实现这种随机呢?
想要真随机,就得去找物理世界里没法预测的现象,比如电路里的热噪声、放射性衰变,甚至敲键盘的间隔;计算机自己关起门来算出来的东西,输入一样结果就一样,天生和随机不沾边。所以现在说的随机数基本都是伪随机,只要周期足够长、分布足够均匀、前后看不出规律,拿去做仿真、采样这些活是完全够用的。
随机算法
随机数对人来说可能是随机的也可能不是,处于量子态,不过目前的计算机所生成的随机数其实不算真随机,而是一种周期很大的循环数,那这样的数怎么生成呢?
所谓循环数,就是拿一个公式反复迭代,序列跑到某一步之后必然从头开始重复,这个步数就是周期。周期越大、分布越均匀,随机数的质量就越高,下面挑几种有代表性的看看。
线性同余法[LCG]
这种方法较为常用,在《C primer plus》中介绍了一段魔术语句,可以实现随机数,那么很多人可能好奇为什么这串代码可以生成随机数,这些已知的数字都是什么含义等等。
1 | |
先看看这串魔术代码在干嘛:把种子seed乘上214013,加上2531011,结果往右移16位,最后和(1<<15)-1按位与,只留低15位。右移16位是为了先取高位,线性同余法算出来的数低位规律性很强,直接拿低位质量很差;取低15位则把输出限制在0~32767之间。
其实学过数学的人都对这种Ax+B的格式不陌生,一般都以线性开头命名,即线性同余算法,这种算法用通式表示为:
其中最大周期为C,A、B均为整数。想取到满周期C是有条件的,也就是Hull-Dobell定理:B和C互质;C的每个质因数都能整除A-1;如果C能被4整除,A-1也要能被4整除。三条缺一不可,参数配不对,周期就会大打折扣。
对于A、B是经过计算得到的,输出范围是 0~(1<<15)-1,可观察到的周期是 2^15。代码中的种子常使用时间,也就是拿time(NULL)的返回值丢进去。这里有个小坑:同一秒里启动两次程序,种子一模一样,生成的序列自然也一样,调试的时候经常被这个坑到。
在C中对应的是srand和rand,用起来大概这样:
1 | |
不过rand() % 100这种写法严格来说有偏差,RAND_MAX+1如果不是100的整数倍,靠前的那些数被多分到一些。想要均匀可以把rand()先换算成[0,1)的小数再缩放,或者直接用C++11的uniform_int_distribution,标准库会帮你处理取模偏差。C++的Random头文件里,minstd_rand用的就是线性同余引擎,只是参数换成了更合适的那组。
平方取中法
这个算法的爹是冯诺依曼,算法主要讲的是:给定一个m位数记作x,其中m是偶数(奇数的话正中间那一位就落到数字缝上了,不好取),计算x的平方,得到2m位数(不足在首端补0)然后从乘积中间得到m位数,然后重复这一步骤。
思路直白得很:一个数平方之后,中间那几位受所有位的影响,看起来和原来的数就没什么关系了。举个4位的例子,种子1234,平方得1522756,补成8位是01522756,取中间4位得到5227;5227平方得27321529,取中间4位得3215;3215平方得10336225,取中间4位得3362,照这样一路算下去就是随机序列了。
它的毛病也明显,中间位里0多的时候数会越缩越小,种子一旦取到0,平方永远是0,序列就死在那了;就算不退化,随机性也比不过后面的算法,所以现在基本只当教学例子。
梅森旋转(Mersenne Twister)算法
梅森旋转的名字来自它的周期$2^{19937}-1$,19937是个梅森素数,所以叫Mersenne Twister。它是1997年松本真和西村拓士提出来的,状态有624个32位字,随机性和周期都远超前面两种,Python的random、C++的mt19937底层跑的都是它,是目前用得最广的伪随机算法之一。
衡量梅森旋转(MT)的质量,需要使用K分布,K分布的定义是:一个周期为T的随机序列Xi,每一位都有w位,当满足下面条件就成为w位的K分布
假设f(x)表示x的前v位形成的数字,并且长度为P的kv位序列:
($f(x_i)$,$f(x_{i+1})$,$f(x_{i+2})$…….$f(x_{i+k-1})$)
其中每个可能出现的$2^{kv}$组合在一个周期内出现相同的次数(除全0序列出现次数比其他序列少1次)
算法需要借助线性反馈移位寄存器(LFSR)生成随机数,主要使用的运算符是异或(xor),我们采用8位寄存器的形式演示,初始化寄存器为10001010,然后定义反馈函数为:
这里为什么用异或而不是加法?因为寄存器上的运算是在GF(2)里做的,每一位只能取0和1,加法和减法都等价于异或。所谓“根据x的重数”,就是看反馈函数里哪几项系数不为0,这里$x^8$、$x^4$、$x^2$和常数1这四项都在,对应的位置就是抽头,每次取第8、4、2、1位做一次异或得到反馈位,然后丢掉最后一位、把反馈位插到首端,循环这个过程多次,就得到了随机序列。这便是旋转的过程。
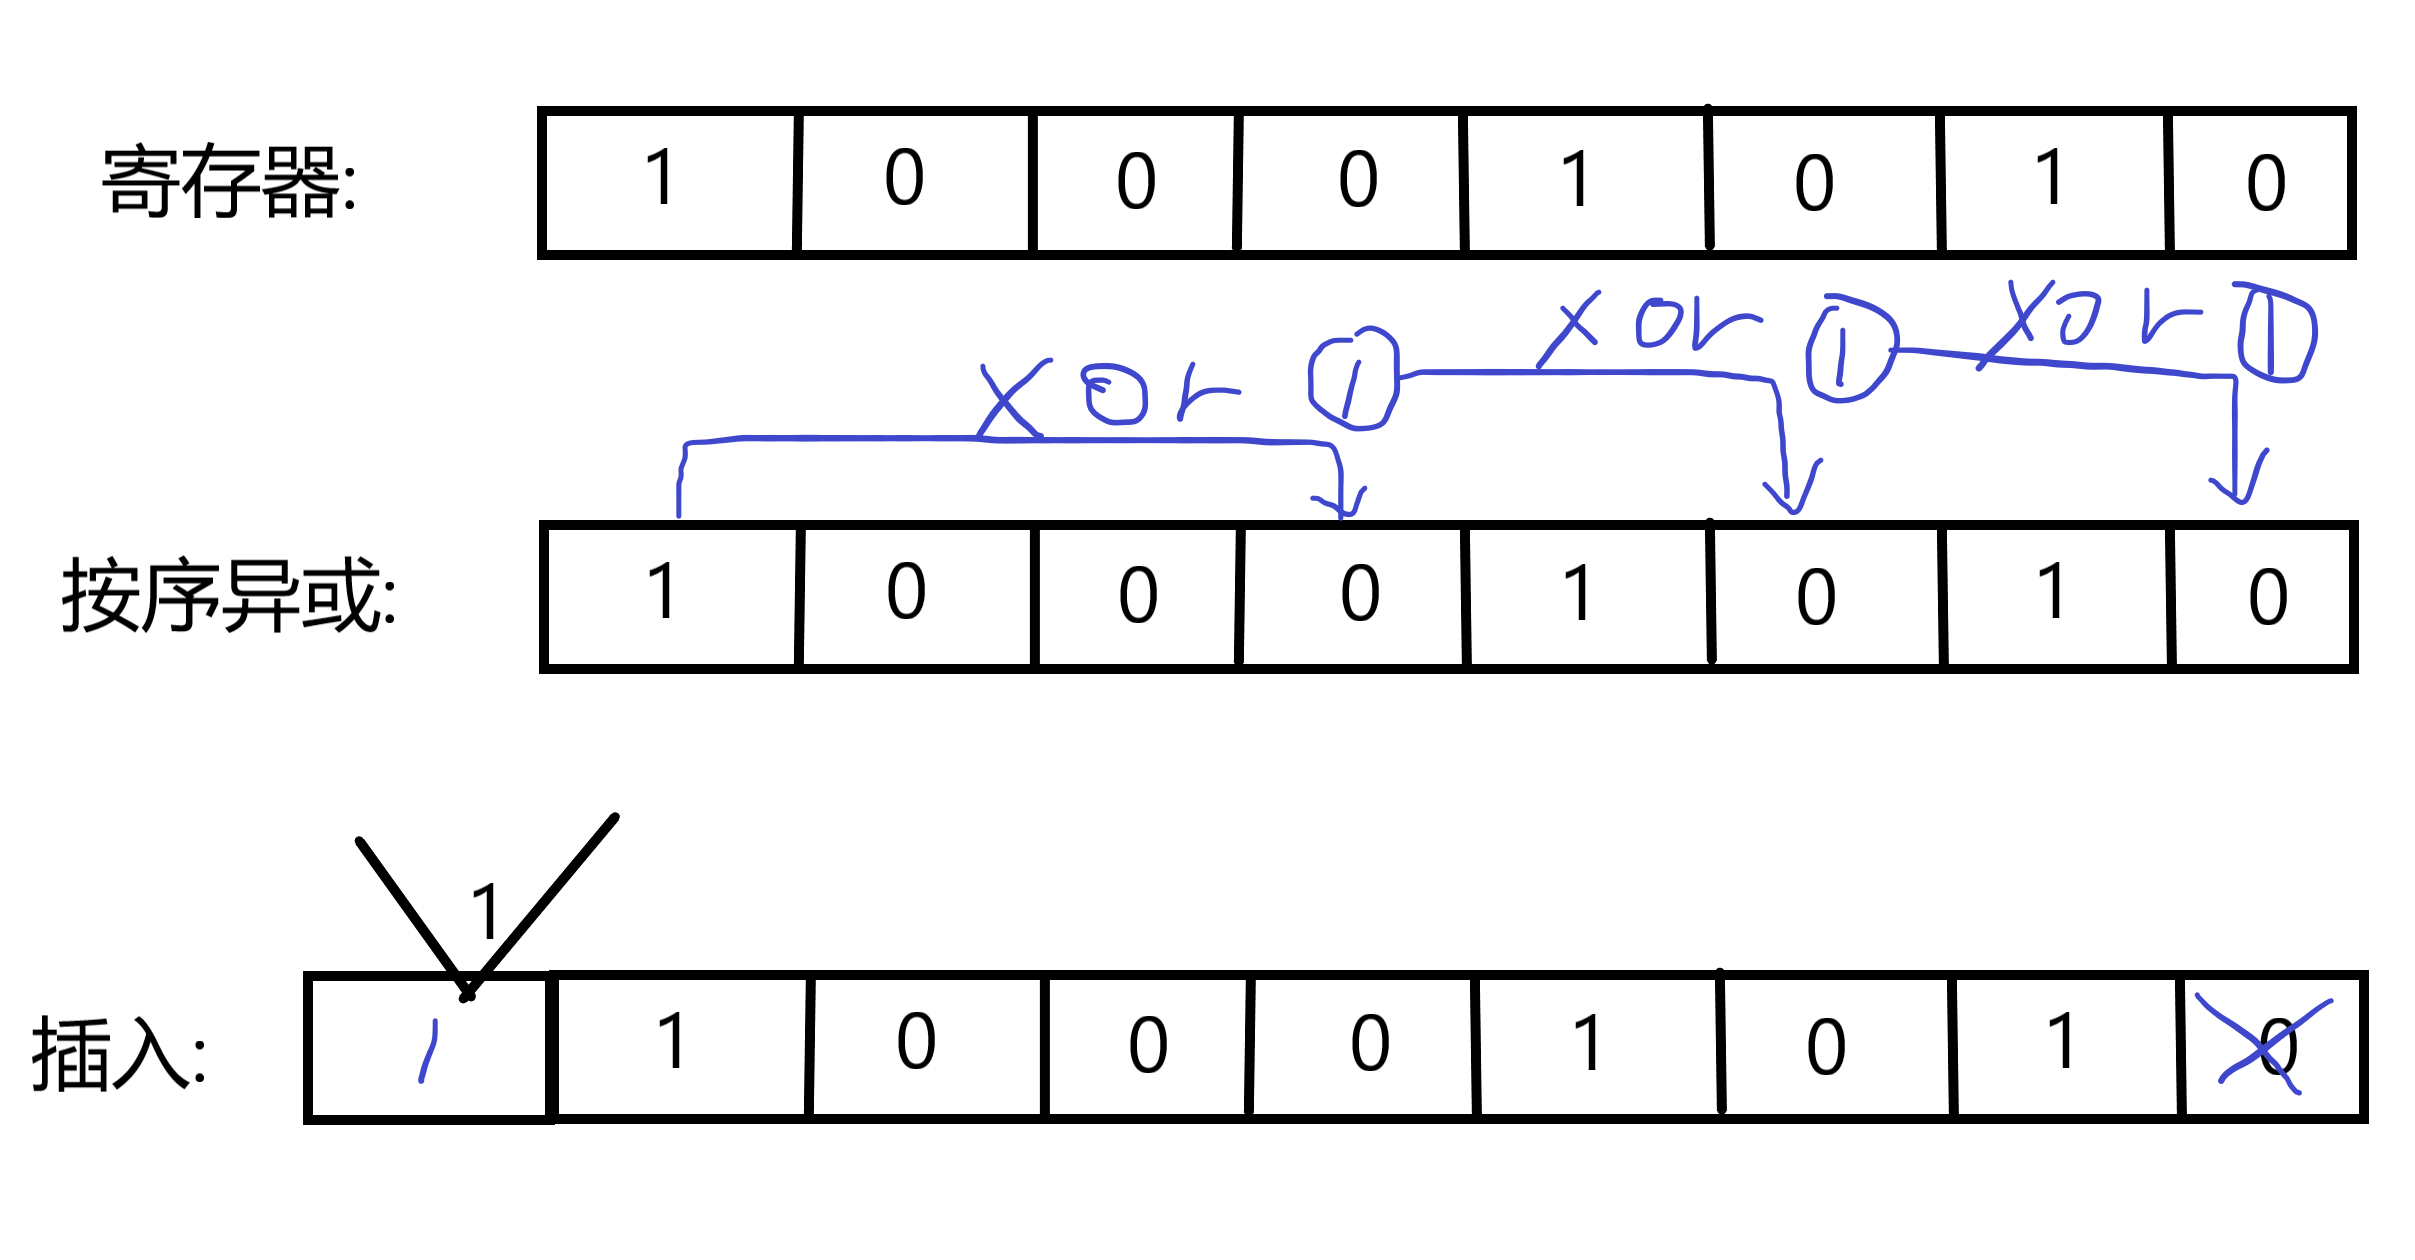
我们使用C++实现这个过程。
1 | |
通过修改传递的MT_random参数就可以得到不同的随机数
当然真正的MT算法比这个演示复杂得多:它的状态是一个624个字的环,旋转的时候用线性变换把相邻的字混在一起,输出之前还要做一遍tempering(回火)把状态彻底打散,随机性才那么好。这里用8位寄存器只是把LFSR的思路演示清楚,代码里主要也是十进制和二进制的互转,加上移位和异或,把刚才的过程串了一遍。
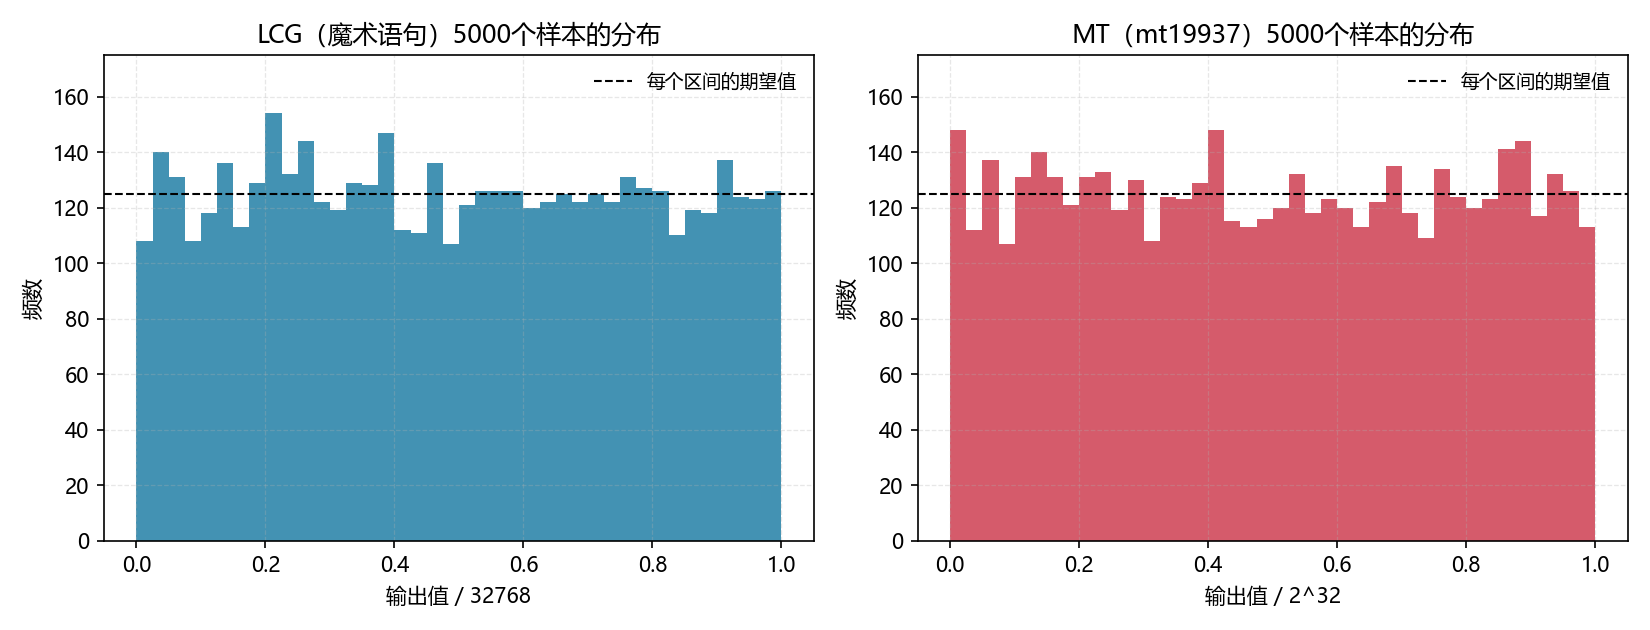
顺手把LCG和标准库的mt19937各跑5000个样本画了下分布,LCG用的还是魔术语句那组参数,两边都挺均匀:
总结
随机数这块就先聊到这,LCG和平方取中法都挺好理解,MT的细节就多了,上面的代码只是拿8位寄存器演示个思路,真正的mt19937还得照着参考资料慢慢啃。平时写代码直接用标准库的引擎就够了,种子也别只拿时间凑数;真要物理随机的话,就得看系统提供的随机源(比如 random_device,注意它不一定真是硬件随机)。
MT算法部分参考: